文本生成模型会根据已有上下文,给出下一个 token 的概率分布。解码策略决定如何从这个分布中选择下一个 token。这里用“单词”帮助理解,但 token 并不一定对应一个完整的词。
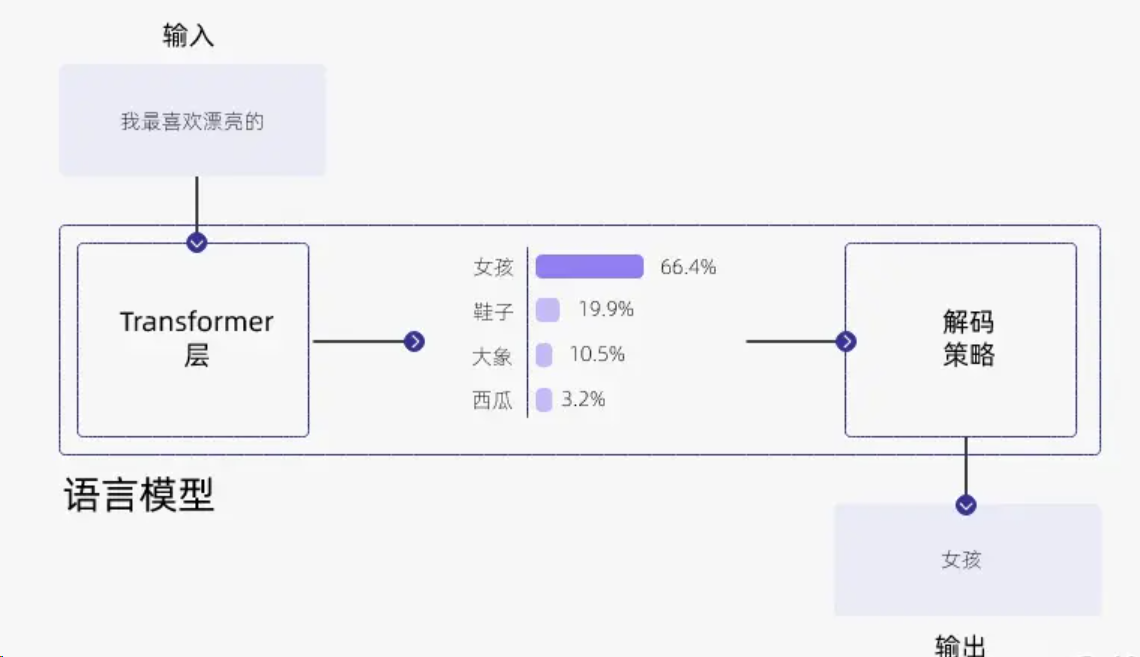
常见的选择方式包括:
- 贪心解码(Greedy Decoding):每一步直接选择概率最高的 token,容易出现重复,也不保证得到整体概率最高的序列。
- 随机采样(Random Sampling):按概率分布随机选择 token,能增加多样性,但也可能选中不合适的低概率 token。
- 束搜索(Beam Search):维护若干条候选序列,每一步扩展候选,再按累计序列得分保留最好的若干条。它可能在开放式生成中产生重复或不够自然的文本。
Top-k 和 Top-p 都属于先筛选候选,再随机采样的方法;Temperature 则用于调整概率分布的形状。
1. Top-k
核心思路
只保留排名前 k 的 token,重新归一化后进行随机采样。k = 1 时只剩下一个候选,效果相当于贪心解码。
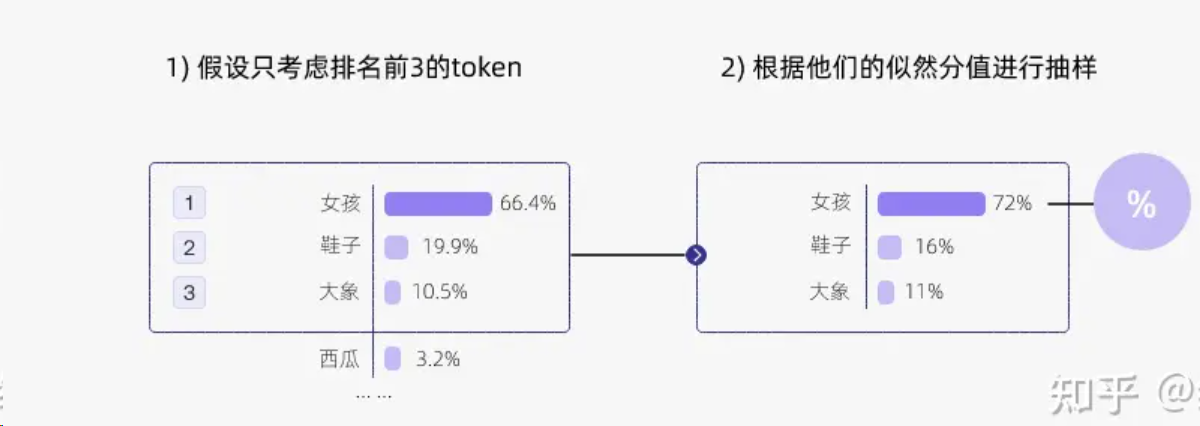
图中右侧的归一化数值有误。按左侧的 0.664、0.199、0.105 计算,保留前三项后的概率约为 68.6%、20.6%、10.8%。
代码示例
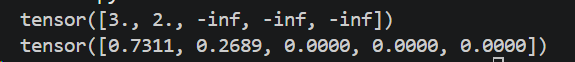
下面用 -inf 屏蔽未入选的 token,使它们经过 softmax 后的概率为 0。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
| import torch
logits = torch.tensor([3.0, 2.0, 1.0, 0.5, -1.0])
def apply_top_k(logits, k):
values, indices = torch.topk(logits, k)
filtered = torch.full_like(logits, float("-inf"))
filtered[indices] = values
return filtered
filtered = apply_top_k(logits, k=2)
print(filtered)
print(torch.softmax(filtered, dim=-1))
|
运行结果:
优点与局限
- 候选数量固定:Top-k 本身不会随分布自动改变
k。分布平坦时,候选之间的概率可能接近;分布尖锐时,采样仍可能主要集中在少数 token 上。
- 可以控制候选范围:增大
k 会纳入更多候选,通常增加多样性,也可能引入不合适的低概率 token;减小 k 会缩小选择范围,但不保证质量一定提高。
- 可以与其他策略组合:例如温度调节、Top-p 或重复惩罚。长度惩罚通常用于序列评分,与单步候选筛选的作用不同。
Top-k 的筛选依据是模型给出的条件概率。这个概率已经包含上下文信息,但按概率筛选并不能保证事实、逻辑或语法正确。另外,固定 k 也可能排除概率较低但合理、有创意的候选。因此,可以进一步考虑 Top-p。
2. Top-p
核心思路
Top-p 也称为核采样(Nucleus Sampling):先按概率从高到低排序,再保留累计概率首次达到或超过 p 的最小候选集合,重新归一化后采样。
与 Top-k 不同,Top-p 的候选数量会随概率分布变化。阈值应根据任务调整,下方代码以 p = 0.9 为例。Top-k 与 Top-p 参数定义
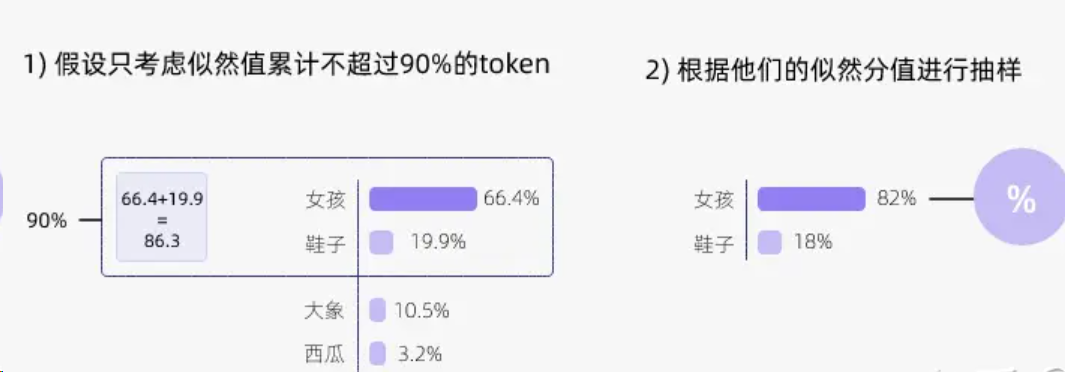
原图把 Top-p 写成了“累计不超过 90%”,并只保留前两项,这是不准确的。前两项之和为 0.863,尚未达到 0.9;加入第三项后为 0.968,所以应保留前三项。图中右侧的 82%、18% 也不是左侧两项归一化后的结果。
代码示例
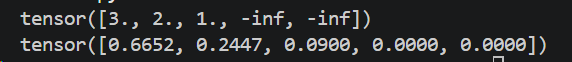
下面的实现会保留使累计概率达到阈值的那个 token:只有前面 token 的累计概率已经达到 p,才屏蔽当前位置。p = 1 时不做筛选。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
| import torch
logits = torch.tensor([3.0, 2.0, 1.0, 0.5, -1.0])
def apply_top_p(logits, p):
if p == 1:
return logits.clone()
sorted_logits, sorted_indices = torch.sort(logits, descending=True)
sorted_probs = torch.softmax(sorted_logits, dim=-1)
cumulative_probs = torch.cumsum(sorted_probs, dim=-1)
remove = torch.zeros_like(sorted_probs, dtype=torch.bool)
remove[1:] = cumulative_probs[:-1] >= p
filtered = logits.clone()
filtered[sorted_indices[remove]] = float("-inf")
return filtered
filtered = apply_top_p(logits, p=0.9)
print(filtered)
print(torch.softmax(filtered, dim=-1))
|
运行结果:
3. Temperature
核心思路
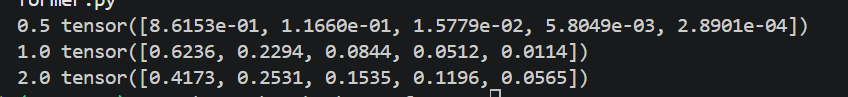
温度调节先将 logits 除以温度 T,再输入 softmax,得到调整后的采样概率。这里要求 T > 0。
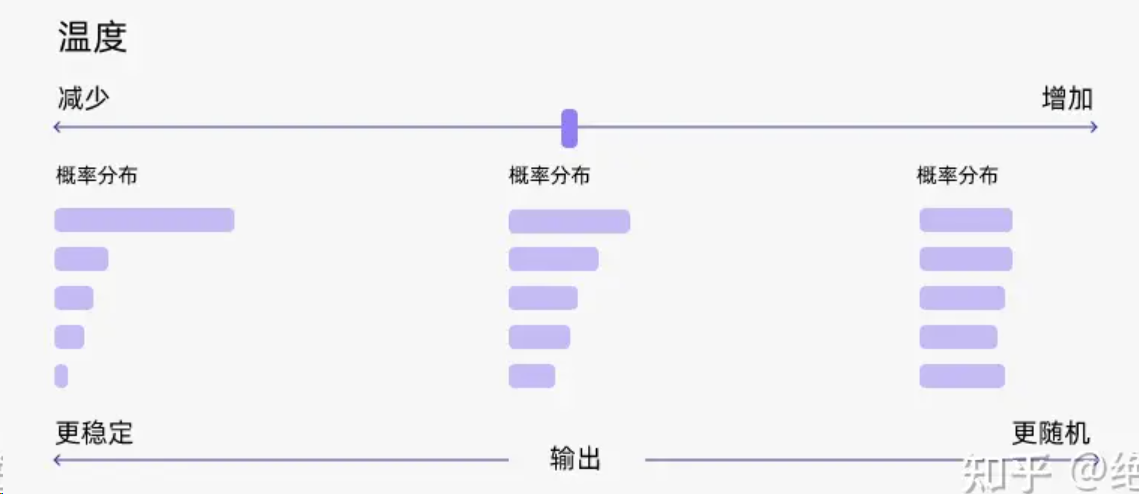
0 < T < 1:分布更尖锐,高概率 token 更占优势。T = 1:保持原始分布。T > 1:分布更平坦,低概率 token 获得更多采样机会。
正温度不会改变 logits 的排名,只会改变归一化后的概率差距。 较低温度通常使采样更集中,但不等于一定生成正确内容。
代码示例
1
2
3
4
5
6
7
8
9
10
| import torch
logits = torch.tensor([3.0, 2.0, 1.0, 0.5, -1.0])
def apply_temperature(logits, tempeature=1.0):
return logits / tempeature
for t in [0.5, 1.0, 2.0]:
probs = torch.softmax(apply_temperature(logits, t), dim=-1)
print(t, probs)
|
运行结果:
4. Top-k、Top-p 与 Temperature 联合使用
处理顺序与示例
下方代码采用 Top-k → Top-p → Temperature → softmax 的顺序。 这不是所有实现都必须遵循的顺序;尤其是 Temperature 与 Top-p 的先后,会影响候选集合,因为 Top-p 依赖调整后的累计概率。
沿用开头图中的分布,先设置 top-k = 3,保留女孩、鞋子、大象。它们的原始概率分别为 0.664、0.199、0.105,归一化后约为 0.686、0.206、0.108。
接着设置 top-p = 0.8:第一项尚未达到阈值,前两项累计约为 0.892,因此保留女孩和鞋子。再设置 Temperature = 0.7,对保留项对应的 logits 做温度调节并重新归一化,结果约为:
代码示例
下面仍使用前面代码中的 logits,并设置 topk = 3、topp = 0.9、temperature = 0.75,因此其输出数值与上面的文字示例不同。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
| import torch
logits = torch.tensor([3.0, 2.0, 1.0, 0.5, -1.0])
def apply_top_p(logits, p):
if p == 1:
return logits.clone()
sorted_logits, sorted_indices = torch.sort(logits, descending=True)
sorted_probs = torch.softmax(sorted_logits, dim=-1)
cumulative_probs = torch.cumsum(sorted_probs, dim=-1)
remove = torch.zeros_like(sorted_probs, dtype=torch.bool)
remove[1:] = cumulative_probs[:-1] >= p
filtered = logits.clone()
filtered[sorted_indices[remove]] = float("-inf")
return filtered
def apply_top_k(logits, k):
values, indices = torch.topk(logits, k)
filtered = torch.full_like(logits, float("-inf"))
filtered[indices] = values
return filtered
def apply_temperature(logits, tempeature=1.0):
return logits / tempeature
def sample_token(logits, topk=1, topp=1, temperature=1.0):
scores = apply_top_k(logits, topk)
scores = apply_top_p(scores, topp)
scores = apply_temperature(scores, temperature)
probs = torch.softmax(scores, dim=-1)
return probs
torch.manual_seed(42)
probs = sample_token(logits, 3, 0.9, 0.75)
print("概率:", probs)
|
运行结果:

关于贪心解码、束搜索和采样的进一步说明,可参考 Hugging Face 解码策略教程。